考虑到不同的业务环境有着很大的差别,虽然说仍然具有一套通用的Checklist,但如果只是把所有可能出现的问题都放到一个大的Checklist,那么就没办法作为实际中的参考了。所以,借鉴《金字塔原理》一书中的处理问题的思路,对本文进行改写,仅提出一个可以参考的解决问题的思路,具体的Checklist则需要自行结合生产环境进行编写。
首先看一下《金字塔原理》第8章对于问题处理的阶段划分,原文的划分包括:
- 界定问题:包括问题是否存在?问题是否可能存在(属于预防的范畴)?以及问题在哪里?
- 结构化分析原因:问题为什么存在?
- 寻找解决方案:我们能做什么?我们应该做什么?
下面结合线上问题的通用组件,进行解释。
界定问题
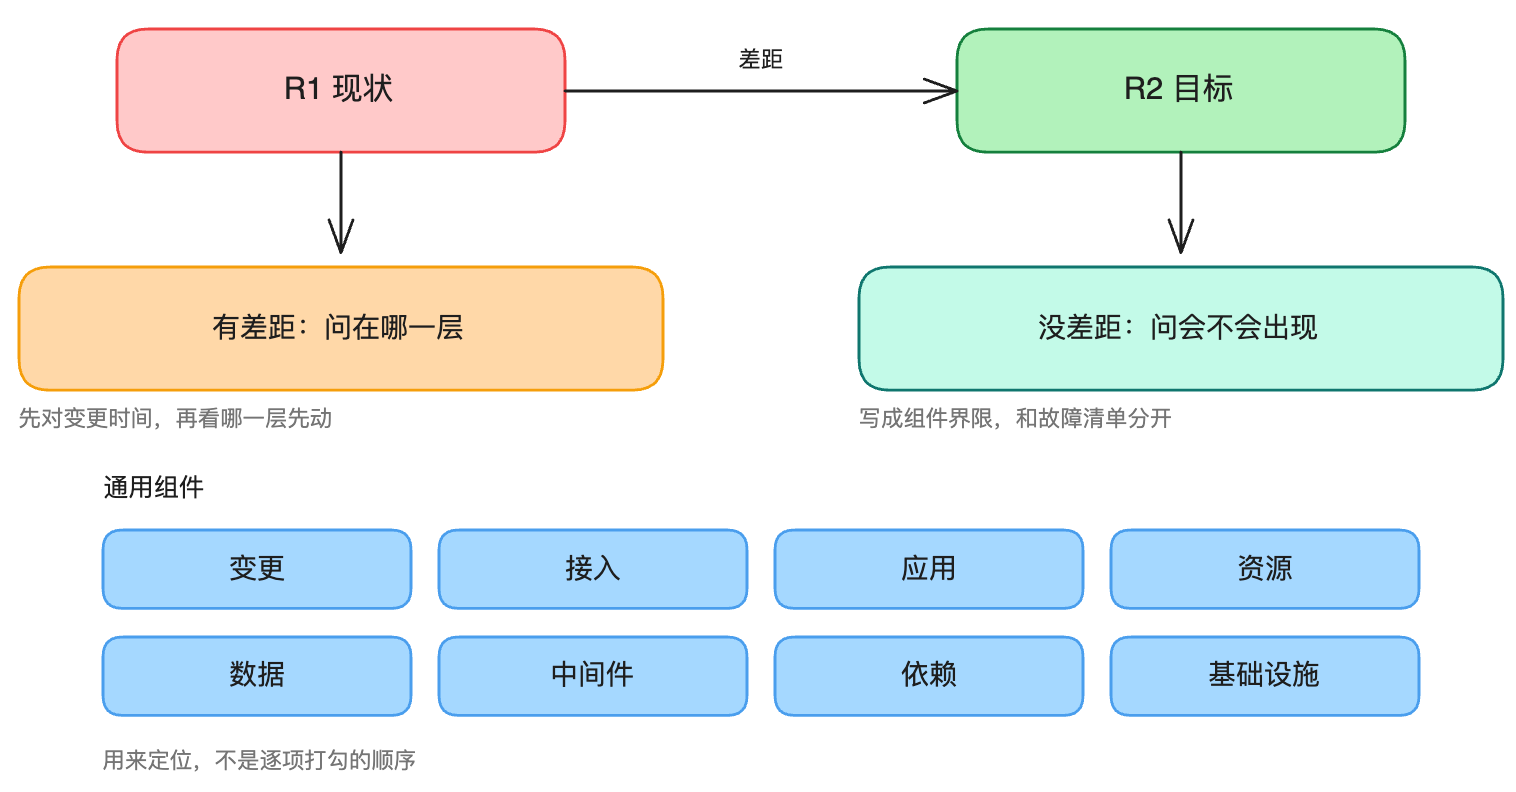
书里把问题定义成现状和目标的差距,现状是 R1,目标是 R2。放到线上,就是先说清哪条路径平时应该是多少、现在是多少、什么事情把原来的稳定打断了。告警和群里的截图只能说明可能有差距,还得用这条路径上的请求量、错误率、延迟、业务成功率去对,不能只看 CPU。资金、订单、库存有没有卷进去要单独看。已经做过的限流、扩容、回滚也要记上时间,不然后面看到的现场是被改过的。
如果这几个数对得上、差距并不存在,再问照现在的结构,差距会不会出现。这是预防,和故障时用的清单不是一回事。预防写到某个组件的界限上就行,比如证书什么时候到期、磁盘还剩多少、连接池要等多久、主从延迟到了多少。故障进行中去补这些,等于又引入一次变更。
差距确认有了,才问它在哪一层。通用组件可以分成变更、接入、应用、资源、数据、中间件、依赖、基础设施,用来定位,不是一条要逐项打勾的顺序。换成自己的环境,就得写成订单库、某个 Redis、某家支付,停在这八个词上仍然没法用。先把差距开始的时间和发布、配置、开关、定时任务、数据订正对一下。时间对得上,变更是位置,还不是原因。对不上,就看哪一层的指标先动。慢 SQL 占住连接,线程堵在取连接,上游开始重试,最后 CPU 和错误率一起高,位置还是在数据库。哪些用户、哪些接口、哪个机房,也是在回答在哪里。
结构化分析原因
第9章讲的是这一步不要先把资料收齐再找结论。告警一来就把 top、线程栈、慢查询、Redis 全部跑一遍,就是这个习惯。先有一个诊断框架,每一支都能用一份证据肯定或否定,再决定取哪份证。
切法就三种。把这条请求实际走过的路径画出来,没走过的组件不要因为万一加进来。看层和层之间交接出去的是什么,慢查询交出去的是被占住的连接,不是「CPU 也高了」这种同时出现的数字。位置已经落到某一层,就按失效方式往下分,不要按命令往下分。比如确定是某条 SQL,就问执行计划变了没有、是不是在等锁、数据分布变了没有、是库先被打满,还是应用在重试。答不上来,就把这一支拆小,或者把缺的证补上。回滚和重启会把现场改掉,还没否定的分支在动作之前留证;已经否定的,不必再去打堆转储。具体命令和开销在文末原文里。
看传播的时候按时间,先变的比最大的那个数更接近原因。几支都成立了,才按严重程度决定先处理哪一支。
寻找解决方案
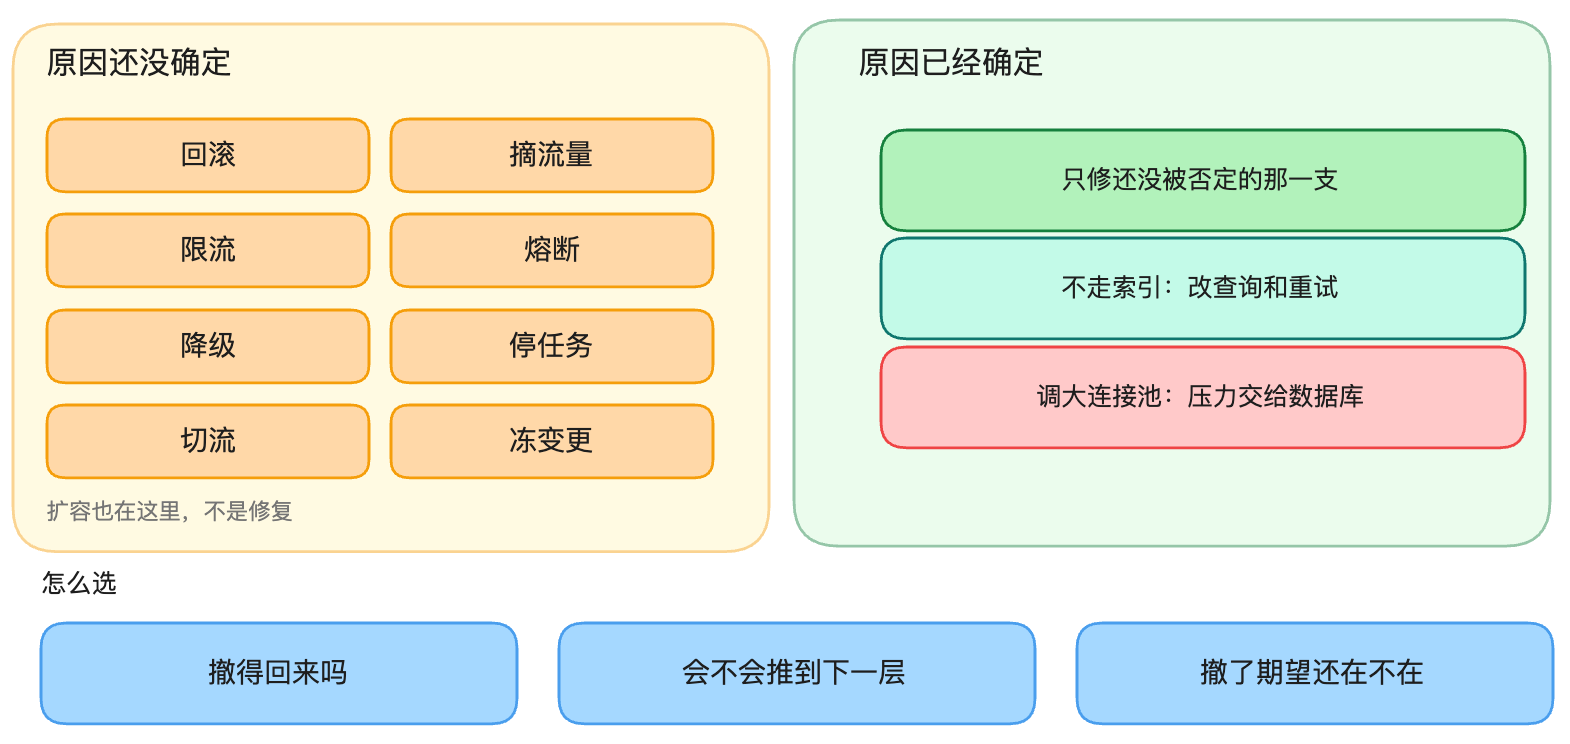
原因还没确定的时候,能做的是让差距别再扩大:回滚、摘流量、限流、熔断、降级、停任务、切流、把别的变更冻住。扩容经常被当成修复,其实也是这一类。修复只对着还没被否定的那一支。查询不走索引,就处理这条查询和它的重试;把连接池调大,只是把压力交给数据库。
几个都能做的时候,看撤不撤得回来,会不会把压力推到下一层,临时措施撤掉之后期望还在不在。主从切换、丢消息、故障现场给大表加索引,撤不干净,等原因更确定再做。订单、库存、资金和消息消费,不要用重试去赌它是幂等的。验收就用界定问题时写过的那组数。限流这些要逐个撤,一撤又坏,说明原因还在。
自己的 Checklist 按实际组件来写:期望是什么,偏离时先回答哪个是或否,哪些动作可以马上撤,哪些要等证据。文末原文是按 Java 后端把常见场景填过一遍的例子,对照某一支成立之后可以看什么,不是要从头勾到尾的模板。
以下是原文,也可作为参考
使用提醒
排查清单不能替代应急预案和故障演练。真正出问题时,先判断故障是否还在扩大,再决定先止损还是先取证。文中涉及的诊断命令都有开销,执行前先确认实例是否仍在承载流量、磁盘余量、命令影响范围和当前时间窗口。
一、接警与影响面确认
- 确认告警来源、级别和触发时间,判断是真实故障还是监控误报、指标采集延迟。
- 确认受影响范围:哪些用户、哪些接口、哪些地域或机房,是否涉及资金、订单、库存等核心链路。
- 查看用户侧指标:请求量、错误率、P95/P99、超时率、业务成功率,而不是只看单机 CPU。
- 判断故障是趋于稳定、已经见顶,还是仍在扩大。
- 拉取告警前后十几分钟的完整指标,把应用、数据库、Redis、MQ、下游和网络放在同一时间轴上。
- 对照最近变更:发布、配置、扩缩容、定时任务、数据订正、第三方变更、流量活动。
- 通知相关方并明确指挥人、沟通渠道和更新节奏,避免多人重复操作。
- 判断是否需要升级响应级别和启动应急预案。
二、止血:先恢复,再定位
止血的目标是控制影响面,而不是找到根因。常见措施都有副作用,选择前先想清楚代价。
- 回滚最近变更:版本、配置、SQL 变更、开关,评估回滚是否兼容已经变更的数据。
- 摘除异常实例:从负载均衡、注册中心摘掉,避免异常实例继续接收流量。
- 限流:对入口或热点接口限制 QPS,保护应用和下游。
- 熔断:对持续失败的下游调用快速失败,防止故障扩散。
- 降级:关闭非核心功能,返回缓存或兜底数据,保住核心链路。
- 停掉异常任务:暂停有问题的定时任务、批处理、异步消费。
- 扩容:评估数据库、缓存和下游容量,避免扩容后把压力推给依赖服务。
- 切换与容灾:主从切换、切流到其他可用区或备用链路。
- 冻结变更:暂停继续发布和其他无关变更,防止叠加影响。
止血不等于解决
限流、降级、扩容只是把影响暂时压住。故障稳定后仍要继续定位根因,并在验证完成后逐个撤销临时措施,否则会留下隐藏的容量或功能风险。
三、留证:重启和回滚之前先做的事
- 保存告警发生前后的监控截图或明确时间范围。
- 备份应用日志、访问日志、错误日志、GC 日志。
- 抓取一到三份间隔数秒的线程栈,而不是只留一份。
- 保留 Trace 中的慢调用、错误调用和上下游耗时。
- 记录进程 CPU、RSS、堆、线程数、文件描述符和网络连接状态。
- 记录数据库慢查询、锁等待、连接池状态、Redis 慢命令和 MQ 积压情况。
- 记录变更记录、发布单和操作日志。
- 提前配置 OOM 自动转储,避免故障后临时手忙脚乱。
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/path/with/enough/space
Heap Dump 有明显开销
手动触发 Heap Dump、类直方图或主动 GC 可能带来明显的 CPU、I/O 和停顿。优先在已摘流量的异常实例上操作,并确认磁盘空间充足。
四、分层定位:先缩小到某一层
暂时没有调用链线索时,按下面的分层顺序逐层排除,不要跳层猜测。
| 层次 | 优先检查 |
|---|---|
| 变更层 | 最近发布、配置、SQL、开关、定时任务、数据订正 |
| 接入层 | DNS、CDN、负载均衡、网关、证书、限流和路由规则 |
| 应用层 | 异常日志、错误率、线程状态、GC、线程池、连接池 |
| 资源层 | CPU、内存、磁盘、网络、文件描述符、容器配额 |
| 存储层 | 数据库慢 SQL、锁等待、主从延迟、Redis、Elasticsearch |
| 中间件层 | 消息队列积压、注册中心、配置中心、分布式锁 |
| 依赖层 | 第三方接口、下游服务、超时和重试配置 |
| 基础设施 | 容器调度、宿主机、内核、网络设备、云平台事件 |
问题经常跨层传播。例如慢 SQL 占住数据库连接,业务线程阻塞在连接池,线程池队列堆积,上游超时重试,最后同时看到 CPU、延迟和错误率上升。按时间线找到最先变化的指标,比盯着最大的那个数字更接近根因。
五、各场景排查清单
CPU 飙高
- 用
top确认高 CPU 是否来自目标 Java 进程。 - 用
top -H -p <pid>或pidstat -t -p <pid> 1找出高 CPU 线程。 - 把十进制线程 ID 转成十六进制,对应到线程栈的
nid。 - 连续抓多份线程栈,确认线程是否长期停在同一段代码。
- 区分是计算热点、死循环、序列化、锁竞争,还是频繁 GC,并确认是否只是流量或重试放大后的正常忙碌。
jps -l
top -H -p <pid>
printf '%x\n' <tid>
jcmd <pid> Thread.print > /tmp/thread-dump.txt
CPU 不高但 Load 很高
- 用
vmstat 1观察运行队列、I/O 等待和阻塞任务。 - 用
iostat -xz 1查看设备利用率、等待时间和队列。 - 确认是否受容器 CPU 限额、网络存储或宿主机 I/O 影响,是否有大量不可中断睡眠。
内存持续上涨与 OOM
- 先分清上涨的是 Java 堆、进程 RSS 还是容器总内存;RSS 涨而堆稳定时,重点看直接内存、线程栈、Metaspace、JNI、本地库和内存映射。
- 查看 JVM 侧数据:堆信息、启动参数、本地内存统计,并根据 OOM 信息判断方向:堆、Metaspace、直接内存、无法创建线程。
- 分析 Heap Dump:占用最大的对象、Dominator Tree 和到 GC Roots 的引用链。
- 沿引用链确认对象为什么被持有;Old 区回收后仍上涨时,关注长生命周期对象、无界缓存、集合持有、监听器或 ThreadLocal。
- 判断是内存泄漏,还是缓存预热、流量增长带来的正常上升。
jcmd <pid> GC.heap_info
jcmd <pid> VM.flags
jcmd <pid> VM.native_memory summary
jcmd <pid> GC.heap_dump filename=/path/with/enough/space/heap.hprof
VM.native_memory 依赖启动时开启的 NMT,例如 -XX:NativeMemoryTracking=summary,故障后无法临时补开。
GC 频繁或停顿变长
- 从 GC 日志确认触发原因、回收前后占用和停顿时间。
- 用
jstat -gcutil <pid> 1000 10连续采样,而不是只看单点。 - Young GC 频繁:看分配速率、存活量和年轻代容量。
- Full GC 频繁:看 Old 区能否回落、晋升速度、Metaspace 和显式 GC。
- 确认 GC 之前是否先出现流量上涨、批任务或缓存刷新。
- 先确认应用行为,再决定是否调参或加堆,避免只是把故障延后。
接口很慢但 CPU 不高
- 从 Trace 找到耗时最长的一段,拆开各阶段耗时。
- 大量线程停在数据库连接池
getConnection():查连接池等待、慢 SQL、长事务。 - 大量线程停在读取下游响应:查下游延迟、超时配置和重试次数。
- 大量线程处于
BLOCKED:查锁持有者和临界区内的慢操作。 - 业务线程空闲但队列堆积:查消费者线程和执行器状态。
- 确认总耗时能否和各阶段对上,补齐缺失的监控或埋点。
线程池队列堆积
- 同时监控线程数、活跃线程、队列长度、队列容量和拒绝次数。
- 比较任务提交速率、完成速率、排队时间和执行时间。
- 抽取正在运行任务的线程栈,确认它们在计算还是等待。
- 检查数据库、HTTP、Redis 连接池是否同步耗尽。
- 评估增加线程数是否会压垮下游。
- 根据任务重要性决定限流、降级、扩容、隔离或丢弃。
数据库连接池耗尽
- 查看活跃连接、空闲连接、等待线程和获取连接耗时。
- 检查 SQL 是否执行慢,导致连接长时间无法归还。
- 检查事务范围是否过大,包含远程调用、文件处理或大量计算。
- 检查是否存在连接泄漏,是否在所有分支正确关闭连接。
- 数据库侧查当前会话、慢查询、锁等待、长事务和实例资源。
- 扩容连接池前,先确认数据库能承受
实例数 × 单实例连接上限的总连接数。
慢 SQL 与锁等待
- 通过慢查询日志或 Performance Schema 找到耗时最长的 SQL。
- 用
EXPLAIN查看执行计划,注意扫描行数、索引使用和额外排序。 - 用生产参数和接近生产的数据分布验证,测试库”走索引”不代表生产一定走。
- 检查锁等待和死锁日志,确认阻塞源头。
- 评估索引变更、SQL 改写和分批查询方案。
相关内容:MySQL 执行计划分析、SQL 优化总结。
Redis 变慢
- 区分是客户端等待还是服务端执行慢。
- 检查连接池等待、网络抖动、DNS 解析和客户端处理。
- 服务端看命令延迟、慢日志、CPU、内存、网络和连接数。
- 排查大 Key、热 Key、过期删除和持久化操作。
- 检查主从复制延迟、集群状态和故障切换。
不要在线执行高开销命令
KEYS *、全量 --bigkeys 等命令会扫描键空间、增加负载。生产环境应选择低峰期、从节点或受控采样,并提前确认命令对当前版本和集群的影响。
消息队列积压
- 比较生产速率和消费速率,确认积压集中在哪个 Topic、队列或分区。
- 检查消费者实例是否存活、消费线程是否阻塞、单条消息处理时间是否变化。
- 排查异常消息不断重试形成的重试风暴。
- 检查分区分配是否均匀、消费者是否频繁 Rebalance。
- 检查消费成功后提交位点是否失败,导致重复消费。
- 增加消费者前确认并行度上限和下游容量,避免恢复后把积压一次性打到数据库。
- 处理期间保证幂等,跳过异常消息时保留内容和失败原因以便补偿。
下游超时与重试风暴
- 把一次调用拆成连接池等待、DNS、建连、TLS、请求、处理和响应读取。
- 检查连接超时、读取超时和调用链总预算是否合理。
- 检查 HTTP 连接池的活跃连接、等待队列和连接复用。
- 检查重试次数、退避策略和触发重试的错误范围。
- 检查熔断器状态、降级结果和首次请求成功率。
- 确认多层重试不会叠加放大流量,非幂等写操作禁止盲目重试。
磁盘、文件描述符与网络
- 用
df -h、du -sh定位磁盘占用,检查日志暴增、大文件、临时文件以及 Dump 或备份。 - 检查文件描述符、连接数和端口占用。
- 用
ss、netstat查看连接状态、TIME_WAIT、CLOSE_WAIT 和重传。 - 检查 DNS、证书、防火墙和网络设备状态。
六、修复与验证
- 修复方案针对根因,而不是只压制现象。
- 变更经过评审,并在接近生产的数据和流量条件下验证。
- 对比故障前、故障中、修复后的同一组指标:请求量、P95/P99、错误率、业务成功率、CPU、内存、GC、线程池、连接池和依赖延迟。
- 确认用户侧指标恢复,业务成功率回到正常水平。
- 涉及订单、库存、资金和重复消费的场景,做数据对账和补偿。
- 逐个撤销临时措施:限流、降级、熔断、扩容、停用的任务。
- 灰度逐步放量,观察足够长的时间后再全量恢复。
相关内容:性能测试入门、超时和重试机制详解、服务降级与熔断详解。
七、复盘与改进
- 记录故障时间线、影响范围和用户表现。
- 分析直接原因、触发条件,以及故障为什么会扩大。
- 整理止血、定位和修复过程中使用的证据。
- 找出哪些监控、预案、测试或流程没有发挥作用。
- 把改进项落到可验证的机制,而不是”加强代码检查”这类空话。
- 为每个改进项指定负责人和完成时间,并跟进闭环。
可落地的改进示例:给连接池等待时间增加告警、限制批量查询条数、为消息消费补充幂等测试、给发布流程增加关键接口对比检查、补充对应场景的压测用例。
八、常用命令与工具速查
| 工具 | 常见用途 | 使用提醒 |
|---|---|---|
top、pidstat | 进程和线程 CPU、I/O | 先确认容器和宿主机观察口径 |
vmstat、iostat | 系统运行队列、内存和磁盘 | 需要结合一段时间趋势 |
jps | 查看 Java 进程 | 仅能列出当前用户的 JVM |
jcmd | 线程栈、堆信息、JFR、类直方图 | 部分命令开销较高,执行前评估 |
jstat | GC 和各内存区域变化 | 连续采样比单点数据更有用 |
| JFR、JMC | CPU、分配、锁、I/O 等事件分析 | 采集配置要结合线上开销 |
| MAT、VisualVM | Heap Dump 分析 | 重点看引用链和 GC Roots |
| Arthas | 方法耗时、线程、类和运行时诊断 | 高流量方法执行 Trace/Watch 要限制范围 |
| Trace/监控平台 | 请求链、错误率、延迟和依赖 | 关注采样率、脱敏和时间同步 |
推荐阅读
- Java 后端线上问题排查:CPU、内存、GC、线程池、连接池、慢 SQL、Redis 和 MQ 积压的完整排查过程。
- JDK 监控和故障处理工具总结:jps、jstat、jmap、jstack、jcmd、JConsole、VisualVM、JMC 等工具。
- 高可用系统设计详解:SLA、单点故障、限流熔断、降级容灾和故障恢复。
- 服务降级与熔断详解、超时和重试机制详解:稳定性治理三件套。
- 性能测试入门:QPS、RT、P90/P99、容量评估和压测。
- 《金字塔原理》[美] 芭芭拉·明托,第8章、第9章