项目受保密协议限制,此处只对整体架构做概述;具体资源并非出自该港口。
项目背景
深圳某港口的实际需求:港区无人车需要根据车流情况提前规划路线,而港内大量外部车辆无法统一通过 GPS 管理,因此需要一套全局平面定位系统,为无人车调度和管理人员提供决策支持。
先前已有团队做过一版,采用摄像头 + 激光雷达方案,并沿用通用检测模型。但港区粉尘大、设备震动强,激光雷达根本稳不住;通用模型对港区专用车辆的识别精度也偏低,导致边缘区域车辆轨迹频繁分裂、全局 ID 无法稳定维持。后来实验室接手,系统切到纯视觉路线并训练港区专用模型,从头把链路跑通。
整体架构
整套系统由一个 React 控制台和四个 Go / Python 服务组成,数据流与控制流分离:视频帧这类高频、大带宽的数据走 ZeroMQ,控制指令与状态事件走 Kafka 4.x(KRaft 模式,无需 ZooKeeper),实时轨迹状态存 Redis,配置与审计落 MySQL。
      前端控制台(React) / 无人车调度系统
         │ 数据流:REST + WS(只读)   │ 指令流:经 API Server
         ▼                          ▼
   ┌──────────────────────────────────────────────┐
   │           HTTP Server (Go/Gin)                │
   │  REST/WS · MySQL(配置/审计) · 读 Redis(实时)   │
   └───┬──────────────────────────────┬───────────┘
       │ 读实时轨迹                    │ 指令 → Kafka
       ▼                              ▼
   ┌────────┐              ┌────────────────────┐
   │ Redis  │              │ Kafka 4.x KRaft    │
   │共享状态│              │ 控制 / 状态事件     │
   └────────┘              └───┬───────────┬────┘
       ▲                       │           │
       │ 写轨迹        region-configs  camera-controls
       │                       ▼           ▼
   ┌──────────────┐   ┌────────────┐ ┌──────────────┐
   │ Vision (Py)  │   │Orchestrator│ │Source Manager│
   │YOLO·MCMVT·映射│   │   (Go)     │ │    (Go)      │
   └──────▲───────┘   └────────────┘ └──────┬───────┘
          │ ZeroMQ PUB/SUB (Protobuf FrameBatch, MJPEG)
          └──────────────────────────────────┘
                     ▲
               多路 RTSP / 本地文件源
Source Manager——视频源统一管理
Go 写的视频源调度器,基于 Goroutine 并发管理多路视频输入,支持 RTSP 拉流与本地文件源,可动态增删、修改配置和重启,无需重启整个服务。用 FFmpeg 解码并按配置抽帧、根据相机标定(位置、畸变)做预处理,再统一编码为 MJPEG,经 Protobuf 的 FrameBatch 通过 ZeroMQ PUB/SUB 分发给 Vision——相比裸 BGR 帧,带宽大约只有 1/30。配置变更由 HTTP Server 经 Kafka 的 camera-controls topic 下发,前端改一下几秒内生效。
Vision——多摄头智能识别
整个系统的算法核心,Python 实现,分三大块:
目标检测:基于 YOLO 的港区专用模型 port_train003,覆盖 5 类目标——集卡、轿车、客车、无人集卡、叉车。训练数据用自托管的 CVAT 标注平台,组织 5 人标注团队完成 7000+ 帧标注并制定标注规范;训练侧配套 CVAT COCO → YOLO 数据集流水线,并用 Ray Tune + ASHA 调度器自动搜超参。在此基础上,平台还在向车牌号 / 港区设备号绑定与人员识别等能力扩展。
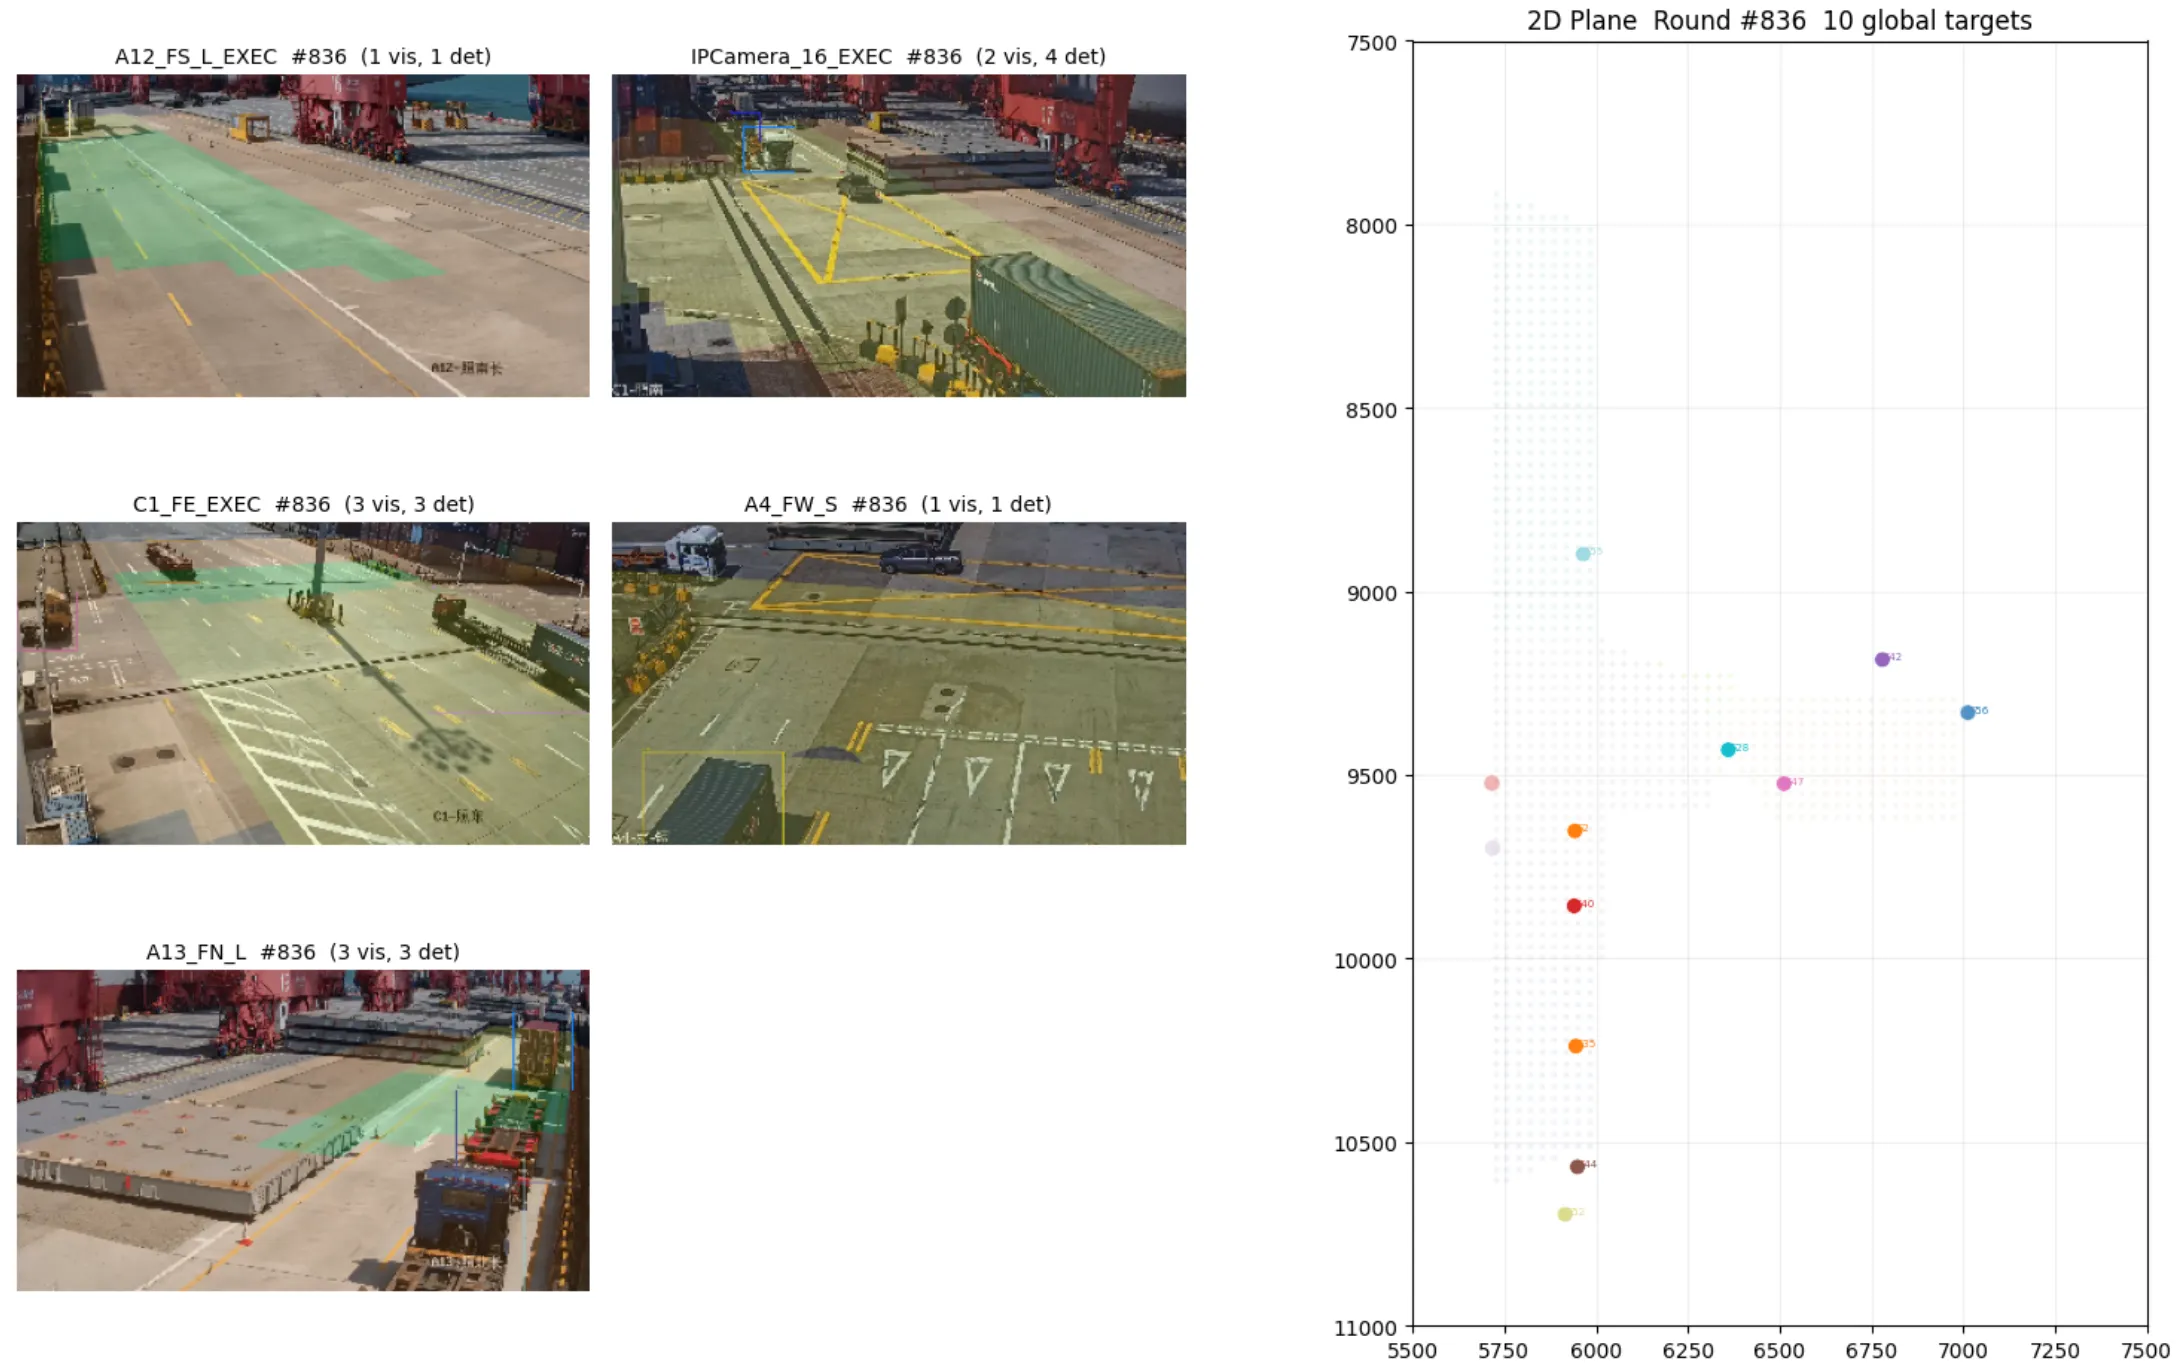
MCMVT 多摄头追踪:花时间最多的部分,核心是「自治区 + 领地管理」。
- 地理位置相邻的摄像头划成一个自治区(Region),各自独立运行追踪器,天然适合分布式;单摄头时跨摄头匹配自动短路,退化为传统 ByteTracker
- 世界坐标网格化,每个格点分配给权重最高的领主摄像头,划分领地与边界缓冲
- 三级优先级掩码(CORE / BUFFER / BOUNDARY)在像素空间过滤检测,控制轨迹生命周期与跨摄头交接
- GlobalByteTracker 在世界坐标系统一管理轨迹,四阶段匹配(同摄头高 / 低分 IoU 两阶段 + 跨摄头马氏 / 欧氏距离两阶段)配合匈牙利算法求解
- 叠加丢失轨迹守恒匹配与 Ghost 吸收,配合世界坐标 Kalman 滤波,轨迹平滑、ID 不分裂
坐标映射:单应性矩阵反算,标定点 → 像素坐标到世界坐标的实时转换,配合出入口区域(Zone)触发轨迹进入 / 离开事件。映射后的世界坐标与轨迹状态写入 Redis,供调度系统和 Web 后端共享。
重识别(ReID):跨摄头车辆重识别是本课题的核心方向。目标是在 MCMVT 的轨迹离开 / 进入钩子上接入 ReID 特征匹配与区域级轨迹库,用时空约束辅助跨区域匹配,最终实现跨区域全局 ID 统一。
HTTP Server——交互中枢
Go + Gin 写的 API 服务,是整个平台和外界交互的唯一入口。前端控制台和无人车调度系统都通过它获取数据、下发指令。设计上严格区分数据流与指令流:
- 数据流(只读):实时目标位置、历史轨迹查询、相机状态、节点心跳、平台统计,直连 Redis,不产生副作用
- 指令流(写):视频源增删改、Region 配置下发、算法参数、服务启停,统一经 CommandBus 落库审计并经 Kafka 下发
- WebSocket 推送:识别结果实时推前端,比轮询有效率得多
- 动态发现:每 10 秒发现新 Region 并订阅,避免服务启动顺序导致的订阅遗漏
位置数据每秒多次更新,不直接写 MySQL——API 读 Redis 返回,响应时间压进毫秒级;配置、指令日志与控制事件则持久化到 MySQL(GORM AutoMigrate)。
Orchestrator——控制流执行器
HTTP Server 只负责把配置变更与服务启停作为「指令」发到 Kafka,真正让它生效的是编排器。Orchestrator 消费 region-configs / service-controls,通过可插拔运行时落地:dry-run(默认,仅演练)或 docker(经 docker.sock 启停容器、按 Region 派生 vision 容器),并把执行结果发布到 service-events,闭合控制回路。
前端控制台
React 18 + TypeScript + Vite + Ant Design 5 的暗色控制台,只与 API Server 交互,数据流与指令流在代码结构和导航上都严格分离。页面包括:实时定位大屏(世界坐标画布、轨迹尾迹、WS 实时流 + 轮询兜底)、状态总览、轨迹查询、视频源管理、Region 配置、算法参数、服务控制、指令审计、控制事件。构建产物输出到 http_server/static/,由 API Server 直接托管。
技术栈
| 层 | 技术 |
|---|---|
| 语言 | Go · Python · TypeScript |
| 消息总线 | ZeroMQ(数据流)· Kafka 4.x KRaft(控制 / 状态流) |
| 推理 | PyTorch · Ultralytics YOLO · OpenCV |
| 后端框架 | Gin |
| 存储 | Redis(实时)· MySQL(配置 / 审计) |
| 前端 | React · Vite · Ant Design |
| 部署 | Docker · Docker Compose · GitHub Actions |
实测结果
在真实港区视频(本地文件源,2 路 1080p @2fps,本机 CPU)上端到端跑通:
| 指标 | 结果 |
|---|---|
| 单帧处理耗时 | 40.7ms(检测 39.1ms + 融合 1.6ms) |
| 处理吞吐 | 232 帧无积压,错误计数 0 |
| REST 延迟 | /health 1.4ms、/regions 1.06ms、/realtime 5.45ms |
| WebSocket | 收到 10 条 track_update(global_id / world_xy / velocity / camera_id) |
| 自动化测试 | 智能识别模块 174 项通过 |
| Redis | 跨摄头全局轨迹完成关联 |
一点体会
这个项目的难点不在某个单一算法,而是真实场景下的工程整合——多路视频的帧同步、不同模块间的通信选型(ZeroMQ 管数据流、Kafka 管控制流,各司其职)、Go 和 Python 跨语言协作,以及配置下发到容器生命周期整条控制回路的打通。前期也没少踩坑,比如最初的激光雷达方案因为港区粉尘和震动根本稳不住。好在后来系统切到纯视觉路线,算是从头折腾到尾把链路跑通了。回头看,这些实践经验比算法本身更有价值。